社内のデータをAIから参照できるようにしたのに、返ってくる答えが毎回違う。その原因は、AIモデルの性能ではなく、データの意味が定義されていないことにあります。そして、その定義を整える作業は、1つの製品では完結しません。
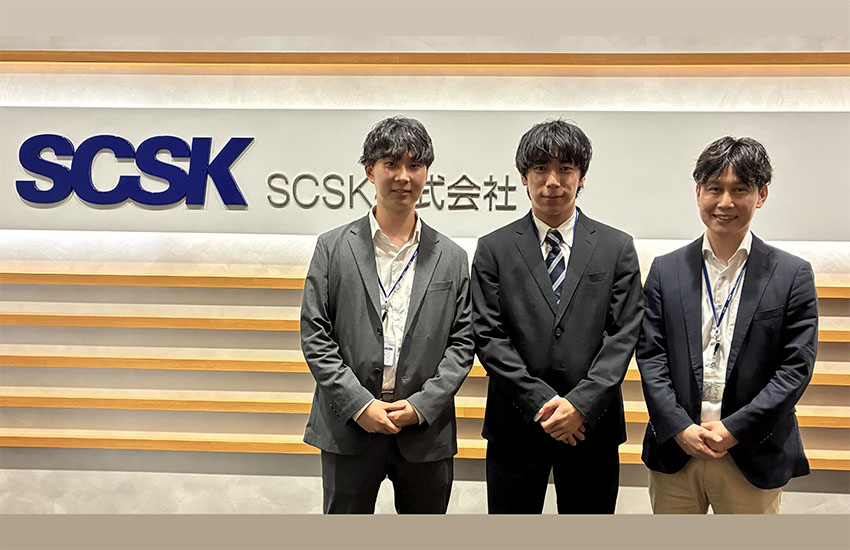
データマネジメント基盤「Dr.Sum」を提供するウイングアーク1st(以下、ウイングアーク)のプロダクトマネージャーである田﨑早瀬氏と、データ連携基盤「ASTERIA Warp」のプロダクトマネージャーである東海林賢史が、AI-Readyなデータとは何か、それを誰がどこまで整えるのかを語りました。前編では、AIの答えが揺れる理由と、AI-Readyなデータの条件を掘り下げます。
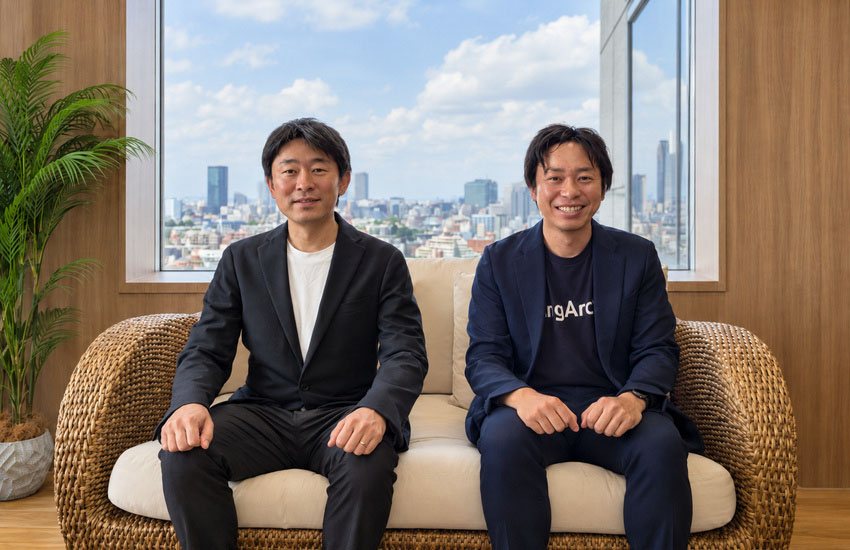 左:アステリア株式会社 ASTERIA Warp プロダクトマネージャー 東海林 賢史
右:ウイングアーク1st株式会社 Dr.Sum プロダクトマネージャー 田﨑 早瀬氏
目次
対談の冒頭、お互いの製品の第一印象を聞いたところ、田﨑氏から返ってきたのは「Dr.SumとASTERIA Warpは似ている」という言葉でした。
田﨑氏 製品の特徴が非常に似ているなと思っています。オンプレミスの時代から長い歴史があり、お客様も多くいらっしゃる。製品の特徴としても、ローコード・ノーコードで利用の視野を広げて民主化する使い方と、エンジニアによるプロコードで高度な使い方の両方に、ハイブリッドで対応できます。そうした二つの面を持っている点で親和性が高いですね。
アステリア側には新鮮な言葉でした。Dr.Sumはデータを貯めて集計する製品、ASTERIA Warpはシステムとシステムをつなぐ製品で、役割としては異なります。それでも似ていると感じる理由は、後編で二人が「自社があえてやらないこと」を語る中で見えてきます。
東海林が語ったのは、Dr.Sumとの最初の出会いでした。
東海林 新卒でこの業界に入った時から、Dr.Sumという製品名は聞いていました。当時、データ分析をするときには、キューブというものを作る必要があり、非常に大変だった。それが不要になる画期的な製品が出てきたという印象でした。そこから20年以上経った現在まで、トップを走っておられる
メタデータがない社内データをAIに参照させると、同じ質問でも答えは毎回変わります。原因は、データの意味が定義されていないため、AIが「どのデータを、どの定義で使えばよいのか」を判断できないことにあります。
そもそも、なぜ社内データなのか。田﨑氏は、AI活用がすでに一般化した領域と、これから企業の差につながる領域を分けて説明します。
田﨑氏 まずAIを導入して成果が出やすい分野は確かにあります。たとえば、外部に公開されているデータを活用する領域です。要約や壁打ち、アイデア出しは、すでに多くの企業が実施している。だからこそ、こうした使い方だけでは差がつきにくくなっています。差が生まれるのは、その先にある社内のデータで、自社のナレッジや暗黙知が蓄積されており、競争優位の源泉になります。これをいかに活用するかが重要だと思っています
田﨑氏が、社内で実際に行った検証の話をしてくれました。
田﨑氏 メタデータを付与していない状態で、MCP経由で『今年度のDr.Sumの売上』という同じ問いをAIに聞きました。結果は、3回ともバラバラで違う回答が返ってきました
同じ問いを、同じデータベースに対して3回聞いたにもかかわらず、なぜ答えが揃わなかったのか。理由を1つずつ挙げてもらうと、AIが毎回、自ら前提を補っていたことが分かりました。
田﨑氏 まず、年度の定義です。AIは、今年度を4月始まりだと思って、4月から集計する。しかし我々の年度は3月始まりです
ウイングアークの年度は3月に始まります。しかし、その前提はデータのどこにも書かれていないため、AIは一般的な4月始まりを採用しました。
次に、集計の対象範囲です。
田﨑氏 ライセンスと言っても、オンプレミスだけなのか、クラウドサービスを含めるのかをAIは判断できない。1回はオンプレミスとクラウドサービスの両方の合算、2回目はオンプレミスだけ、みたいな形でばらつきがありました
同じ「売上」でも、何を含めて何を含めないか、の定義が決まっていない。AIは1回目と2回目で違う判断をすることになりました。
そして3つ目が、参照するデータそのものです。
田﨑氏 さらに、参照する売上テーブルも3回とも異なり、結果として毎回違う数字を出してきました
起点や範囲、見ているテーブルまで違う。3回とも違う数字になるのは当然の帰結でした。
では、メタデータで意味付けをするとどうなるのか。
田﨑氏 これをカタログで意味付けすると、3回とも同じ前提に基づいて、正確に回答するようになります
同じAIに、同じ質問を投げています。変わったのは、AIに参照させるデータ側の情報です。
問題は、社内で当たり前に使っている言葉の意味が、1つに決まっていないことです。
田﨑氏 同じ売上という言葉だけをとっても、それが請求上のものなのか、受注上のものなのか、どちらを指すのかをAIは判断できません
人間であれば、社内の文脈から意味を補えます。前任者から引き継いだ暗黙の了解や、部署ごとの慣習が、数字の前提を支えている。その前提はデータそのものには書かれていないため、AIは毎回、前提を選び直してしまいます。
アステリアの営業の現場でも、人間同士で似た場面があります。この項目はどういう経緯で作られたのか、このデータは結局何のデータなのか。聞かれても説明できない、ということは起こります。目的があってデータを集めても、集めたデータの意味が目的と合っていなければ使えません。
データの意味が定義されていないことは、原因の1つです。
どれを使うべきかが決まっていないと、AIは手近なものを選びます。なぜそのデータを参照したのかは記録に残らないので、後から調べようがありません。
東海林が挙げたのは、データの鮮度でした。
東海林 企業の中に集まっているデータを見ていくと、今生きているデータと古くなってしまったデータが、かなり混在していることがあります。そこをどう切り分けるのか。いかにデータの鮮度を保つのか。そういったところは、全体的な設計の工夫が必要なポイントかなと思っています
意味が定義されていない。似たデータが複数あり、どれを使うべきか決まっていない。生きているデータと古くなったデータが混ざっている。この3つが重なった状態のままだと、AIの性能が上がっても、答えは安定しません。
AI活用が進まない理由として「導入自体が目的になってしまう」という指摘はよく聞かれます。アステリアでも、社内にデータがたくさんあるから分析してみてほしい、と目的のないまま頼まれた経験があります。
AI-Readyなデータとは、AIが処理しやすい形式に整えられ、何を意味するかが定義され、誰が見てよいかが統制されたデータのことです。何をどう定義するかは、そのデータを誰が何のために見るのかで決まります。
田﨑氏は3つの要素で答えました。
田﨑氏 1つ目はデータの正確性と完全性、つまり社内で承認された正しいデータであること。2つ目は意味付けと定義。3つ目はセキュリティとアクセス権です。そもそも本当にAIにアクセスさせていいデータなのかを管理することも、AI-Readyなデータに必要な要素だと思っています
2つ目の意味付けと定義には、前章の「売上」の例がそのまま当てはまります。
東海林の答えは、2つの軸でした。
東海林 AI-Readyには、AI-Readyなデータと、AI-Readyなツールという二軸があると考えています。データ側について言えば、AIが処理しやすい形式に整形されていること。そして、情報の意味や文脈が失われないよう、必要な情報が揃っていることです
データマネジメント基盤とデータ連携基盤で別々の視点ですが、二人とも同じところに行き着きます。データの中身が整っているだけでは足りず、その意味が付いていなければAIは使えない、という点です。田﨑氏の挙げた正確性・完全性、意味付け、セキュリティの3つは、アステリアから見ても外せない条件です。
東海林は、形式を整えることの限界にも触れました。
東海林 AIは画像なども処理できます。ただ、非構造化データをそのまま大量に蓄積してAIに処理させようとすると、処理の精度は出ませんし、AIのトークンもかなり消費してしまう。一度、非構造化データを構造化する処理を挟んで、構造化データとして蓄積しておく。そのうえで別のAIで分析するという使い方のほうが、扱いやすくなると考えています
東海林は、AIに関わるデータ処理を3つに分けて捉えています。非構造化データを構造化する「前処理」、構造化したデータをAIに渡して分析させる「本処理」、そして本処理の結果を確認して基幹システムへ取り込む「後処理」。いま述べた構造化は、このうちの前処理にあたります。
一方で、整えすぎることの弊害もあると東海林は言います。正規化を突き詰めたデータの一部だけを切り出して渡すと、必要な情報が欠けてしまう。ある程度まとまりを持たせて非正規化したデータのほうが、AIには扱いやすい場合がある。形式を整えることと文脈を保つことを、目的に合わせて使い分ける必要があります。
最初に決めるのは、そのデータを誰が何のために見るのかです。用途が決まってはじめて、必要なテーブル設計とメタデータが決まります。
では第一歩は何か。この問いに、二人は違う答えを返しました。
東海林の答えは、データの棚卸しでした。
東海林 第一歩としては、少しレイヤーが違う話かもしれませんが、社内にどういうデータがあるのかを確認し、それらの意味的なつながりを把握することだと思います
そのうえで技術的な段階に進むと、Excelやシステム内のデータベース、ファイルで持っているものを共通のデータフォーマットに変換すると同時に、セマンティックなメタデータを用意して付けていきます。棚卸しの次が変換とメタデータ、という順番です。
田﨑氏の答えは、その一段上にありました。
田﨑氏 これを使って何をしたいのか、まずは目的を確認します。誰がどういう位置づけでこれを活用したいのかが決まってから、お話をします。Aさんがこういう用途で見たいのであれば、データとしてはこういうフォーマットで、こういうデータが必要ですよ、という設計が必要になります
この2つを組み合わせると、次のような順番になります。
このうち、散らばったデータを集めて共通のフォーマットに変換するところが、アステリアの仕事です。
この順番には理由があります。メタデータに一般解がないからです。「今年度は3月始まり」という定義が正しいのは、その会社の、その用途においてだけ。誰が何のために見るのかが決まらなければ、何をどう意味付ければよいかも決まりません。田﨑氏は、目的が決まった後の手順として、テーブル設計、メタデータの付与、そしてAIがどのテーブルまで見てよいかの設定という3つを挙げています。
ウイングアークは、Dr.Sumのデータカタログでメタデータを付与できるようにしています。この売上データはどのシステムから来て、どういう時に使うものなのか、といった情報を定義しておく機能です。
ツールの前に決めることがある、という点は、アステリアも同じ立場です。
東海林 目的がはっきりしていなかったり、何でもいいからAIを入れようという話になると、ツールを入れればいいんでしょう、という短絡的な考えになってしまうこともある。そういうときには、ツールだけではないという話をさせていただきます
AI-Readyなデータの条件は4つです。誰が何のために見るのかが決まっていること。言葉の定義が社内で1つに決まっていること。どこに何があるか棚卸しされていること。AIが見てよい範囲が決まっていること。
前編の要点は、次の3つです。
残るのは、それを誰がどこまでやるのか、という問いです。後編では、両社が「あえてやらないこと」を紹介します。貯める製品とつなぐ製品が互いを「似ている」と感じる理由も、そこではっきりします。あわせて、全社のDWHがあれば現場のデータも集まるのか、分析結果をどう業務に戻すのかを扱います。
ウイングアーク1stが主催するカンファレンス「UpdataNOW26」が開催されます。今年のテーマは「AI時代のデータリアリズム」、そして「今こそユーザー主権を」。ASTERIA Warpのブースもございますので、ぜひ、お立ち寄りください。
PM・SE・マーケティングなど多彩なバックグラウンドを持つ「データ連携」のプロフェッショナルが、専門領域を超えたチームワークで「データ活用」や「業務の自動化・効率化」をテーマにノウハウやWarp活用法などのお役立ち情報を発信していきます。




Related Posts
ASTERIA Warp製品の技術情報やTips、また情報交換の場として「ADNフォーラム」をご用意しています。
アステリア製品デベロッパー同士をつなげ、技術情報の共有やちょっとしたの疑問解決の場とすることを目的としたコミュニティです。